- Data Analytics
- M2
Daten sind harmlos, bis jemand auf ihnen entscheidet
Warum Datenmängel oft erst im Ernstfall auffallen und wie man sie sichtbar macht, bevor auf ihnen entschieden wird.
Weiterlesen
Teil 1 der Reihe zur Datenqualität im öffentlichen Sektor.
Die meisten Daten der Verwaltung führen ein ruhiges Leben. Sie werden erhoben, gespeichert und veröffentlicht, weil eine Pflicht es verlangt. Ob sie stimmen, fragt kaum jemand, solange niemand auf ihnen entscheidet.
Für die Luftqualität endet diese Ruhe bald. Ab 2030 gelten in der EU deutlich strengere Grenzwerte. Nach der vorläufigen Auswertung des Umweltbundesamts lagen 2025 rund 39 Prozent der Messstationen über dem künftigen Jahresmittel für Stickstoffdioxid und rund 18 Prozent über dem für Feinstaub PM2,5. Das Amt erwartet bis 2030 weitere Verbesserungen. Wo Werte knapp bleiben, entscheiden die Daten.
Länder und Kommunen werden Maßnahmen prüfen und beschließen, auf Grundlage von Messdaten, die heute schon öffentlich bereitstehen. Dann hängt an den Daten etwas: Fördergeld, eine Begründung gegenüber dem Rechnungshof, das Ergebnis einer KI. Aus einer Bereitstellungsaufgabe wird eine Entscheidungsgrundlage. Die Zeit zum Prüfen fehlt dann meist.
Wie schnell das gehen kann, habe ich auf der Smart Country Convention 2026 im Workshop „Datenqualität sichtbar machen“ an einem Szenario gezeigt. Ein Land vergibt ab 2027 Fördermittel für saubere Luft, maßgeblich ist die NO₂-Belastung je Kreis. Die Grundlage liegt bereit: offene Messdaten von Bund und Ländern, 5,1 Millionen Tageswerte seit 2016, aufbereitet in einem übersichtlichen Dashboard. Das Förderprogramm ist erfunden, die Daten sind echt.
Dann kam die Frage an die Runde: Würden Sie auf dieser Grundlage eine Förderentscheidung treffen?
Alle schüttelten den Kopf. Das Bauchgefühl lag richtig. Begründen lässt es sich aber erst, wenn man die Daten selbst befragt.
Der erste Blick gilt meist der Abdeckung, und er zeigt eine deutliche Lücke. In 155 von 400 Kreisen und kreisfreien Städten liefert keine Station einen NO₂-Jahreswert für 2025. In 144 davon gibt es für 2025 von keiner Station einen Jahreswert, für keinen einzigen Luftschadstoff.
Im Szenario heißt das: Diese Kreise erhalten keine Förderung, unabhängig davon, wie belastet die Luft dort tatsächlich ist. Kein Messwert, keine Förderung. Ein Datenfehler ist das nicht. Es ist eine Grenze des Messnetzes, und sie fällt auf, sobald man nach der Abdeckung fragt. Darin liegt die Falle. Wer diese Lücke gefunden hat, glaubt, die Daten geprüft zu haben, und vertraut dem Rest. Der Rest hält einer genaueren Prüfung nicht stand.
Im Workshop habe ich nicht gefragt, woher ein Wert stammt, sondern ob er die Entscheidung tragen kann, die auf ihm beruhen soll. Das meint Datenqualität: Daten, die für ihren Zweck taugen. Messbar wird sie mit sechs Dimensionen, die DAMA UK 2013 beschrieben und die britische Regierung 2020 in ihr Government Data Quality Framework übernommen hat. Andere Rahmenwerke unterscheiden mehr Merkmale, für einen ersten Blick reichen diese sechs.
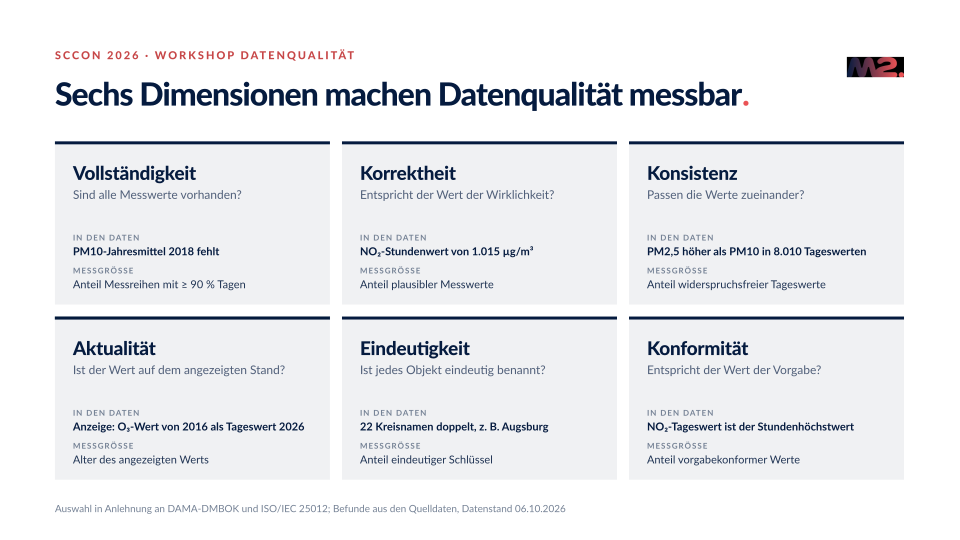
Aus dem SCCon-Workshop: jede Dimension mit einem echten Befund aus den Luftdaten und der Kennzahl, mit der er sich messen lässt.
Für die Förderung hätte das Folgen. Wer Kreise über den Namen zuordnet, schickt Geld an den falschen Kreis. Wer den NO₂-Tageswert wie einen Durchschnitt behandelt, schätzt die Belastung zu hoch ein. Zur Einordnung: 96 Prozent der Messreihen erreichen die nötige Abdeckung. Der Ozonwert von 2016 ist in den Quelldaten korrekt datiert und verrutscht erst in der Aufbereitung. Jeder dieser Befunde war vor dem Start messbar. Manche entstehen in der Messung, andere erst in der Verwendung. Woher sie kommen und warum gerade die späten teuer werden, zeigt Teil 2.
Was wir daraus lesen: Die sechs Fragen passen auf jeden Datensatz, ob Fördergeld, Register oder KI-Anwendung. Wer heute misst, kann morgen belegen, dass seine Daten besser geworden sind.
Messbar waren die Befunde also. Bekannt war keiner, bis jemand danach gefragt hat. Im Workshop habe ich das Intransparenz genannt, und sie hat drei Formen. Niemand weiß, wie gut der Bestand ist. Niemand ist für seine Qualität benannt. Im Lastenheft steht Datenqualität selten, die Folgen zeigen sich erst im Betrieb.
Das Muster ist kein Sonderfall der Luftdaten. In einer offenen, nicht repräsentativen Umfrage des IT-Planungsrats mit 1.459 Teilnahmen messen 74 Prozent der Antwortenden der Datenqualität einen hohen Stellenwert bei. Klar geregelte Verantwortlichkeiten haben nur 10 Prozent. Laut PwC erfassen zudem bis zu 15 Register dieselben Angaben, teils mit abweichenden Einträgen. Der Druck wächst. Die Bundesregierung will, wo möglich, einen Rechtsanspruch auf offene Daten schaffen. Der Bundesrechnungshof weist darauf hin, dass Nutzende qualitativ hochwertige Daten dann notfalls einklagen könnten.
Was wir in Projekten sehen: Gute Datenqualität bemerkt niemand, eine falsche Zahl sofort. Deshalb wird das Thema verschoben, bis die Zeit fehlt.
Wer entscheidet, braucht keine perfekten Daten. Er braucht die Antwort auf die Frage vom Anfang: Hält meine Entscheidung, wenn jemand nachprüft?
Die Antwort beginnt mit Sichtbarkeit. Bei M2. arbeiten wir dafür nach einem eigenen Data Quality Framework. Wir legen fest, wo im Datenfluss gemessen wird, und definieren mit dem Fachbereich Prüfregeln mit Sollwert, im Luftbeispiel 20 Regeln in sechs Dimensionen. Jede Regel hat eine verantwortliche Stelle: Unplausible Messwerte korrigieren die Messnetze, Fehler in der Aufbereitung behebt der Dienstleister. Die Prüfungen beobachten nur, sie greifen nicht in die Daten ein. Am Ende steht eine bewusste Entscheidung: beheben, akzeptieren oder offenlegen. Die 155 Kreise ohne NO₂-Wert lassen sich nicht schnell beheben. Ob man sie anders berücksichtigt, ist eine politische Frage. Beantworten lässt sie sich nur, wenn die Lücke sichtbar ist.
Unsere Empfehlung: Klein anfangen. Ein Datensatz, die sechs Fragen und eine siebte vorweg: Wer ist für die Qualität dieses Datensatzes benannt? Wer früh misst, entscheidet in Ruhe.
Im zweiten Teil gehen wir den Fehlern auf den Grund: wie sie sich einschleichen, warum sie bei Migration, Dashboard und KI teuer werden und wie die 20 Prüfregeln im Detail arbeiten. Teil 2 erscheint am 10. November.
Direkt per Newsletter erhalten.
Beruht auf Ihrem Datensatz bald eine Förderrichtlinie, ein Bericht oder ein öffentliches Dashboard? Im kostenlosen, 30-minütigen Erstgespräch gehen wir die sechs Fragen anhand Ihrer Beschreibung durch, ohne dass Sie Daten herausgeben müssen. Erstgespräch vereinbaren
Wer Daten veröffentlicht, findet im Whitepaper „Die letzte Meile öffentlicher Daten“ einen Leitfaden, wie Behörden Daten in wenigen Tagen verständlich bereitstellen, mit Prüffragen und einer FAQ zur Datenqualität.
Quellenanhang
Warum Datenmängel oft erst im Ernstfall auffallen und wie man sie sichtbar macht, bevor auf ihnen entschieden wird.
Weiterlesen
Die wichtigsten Studienergebnisse zu Wachstum, Budgets und KI-Reife.
Weiterlesen
Wie Behörden Daten schneller, verständlicher und wirtschaftlicher nutzbar machen.
Weiterlesen
Wann und wie Sie Multi-Fact-Relationships in Tableau verwenden
Weiterlesen
M2 bietet Unternehmen maßgeschneiderte Lösungen für ein nachhaltiges ESG-Reporting
Weiterlesen
Rückblick auf unser Event im Halleschen Haus in Berlin-Kreuzberg
Weiterlesen
Teil 2 von 2: KPIs & Rollen
Weiterlesen
Teil 1 von 2: Einführung & Reporting
Weiterlesen